O essencial da semana
- A Anthropic lançou o Claude Sonnet 5.5 em 28 de setembro mantendo a tabela de preço do modelo anterior: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída.
- O ganho anunciado não está no preço, está no consumo: a Anthropic afirma que o modelo custa até 30% menos por tarefa porque precisa de menos tokens para o mesmo trabalho. É afirmação do fornecedor, medida nos benchmarks dele.
- O Barclays aparece em 1º de outubro com números de escala de uso interno: mais de 16 mil funcionários no assistente de conhecimento e mais de um milhão de buscas. São números de adoção, não de resultado.
- Em 2 de outubro a Anthropic anunciou US$ 100 milhões para formar 10 mil engenheiros de implantação até o fim de 2027 — um sinal de onde ela enxerga o gargalo: não no modelo, na implantação.
- Nas trilhas de WhatsApp e de métricas de escritório, esta edição não traz novidade, e o motivo não é "não aconteceu nada". As fontes primárias das duas estavam inacessíveis a partir do ambiente desta execução. O detalhe está em cada seção.
IA aplicada
Em 28 de setembro a Anthropic lançou o Claude Sonnet 5.5. A tabela de preço não mudou: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, os mesmos valores do Sonnet 5, com leitura de cache a US$ 0,20 e escrita a US$ 2,50 por milhão. Quem olha só a tabela conclui, corretamente, que o preço unitário ficou parado.
A afirmação do anúncio é outra. O modelo custaria "até 30% menos por tarefa" porque precisa de menos tokens para chegar ao mesmo resultado. O preço por unidade continua igual; o que teria caído é o número de unidades consumidas por trabalho entregue.
Essa distinção não é retórica de release. Ela troca o número que um escritório precisa acompanhar.
Se o preço por token é tabelado, a conta do mês é preço × tokens. O primeiro fator não está na sua mão: é tabela pública, igual para todo mundo. O segundo está. E ele não é governado só pelo modelo — depende de quanto contexto você empurra em cada chamada, de quantas idas e voltas um atendimento leva até resolver, e de quanto do histórico da conversa é reenviado a cada turno.
Daí sai a métrica utilizável: custo de IA por atendimento resolvido. Não custo por token, que você não controla, nem custo por mensagem, que mede outra coisa. Ela se calcula com o que você já tem: pegue a fatura de IA do mês e divida pelo número de atendimentos que chegaram ao fim. É um número em reais, comparável mês a mês — e, principalmente, comparável entre tipos de atendimento.
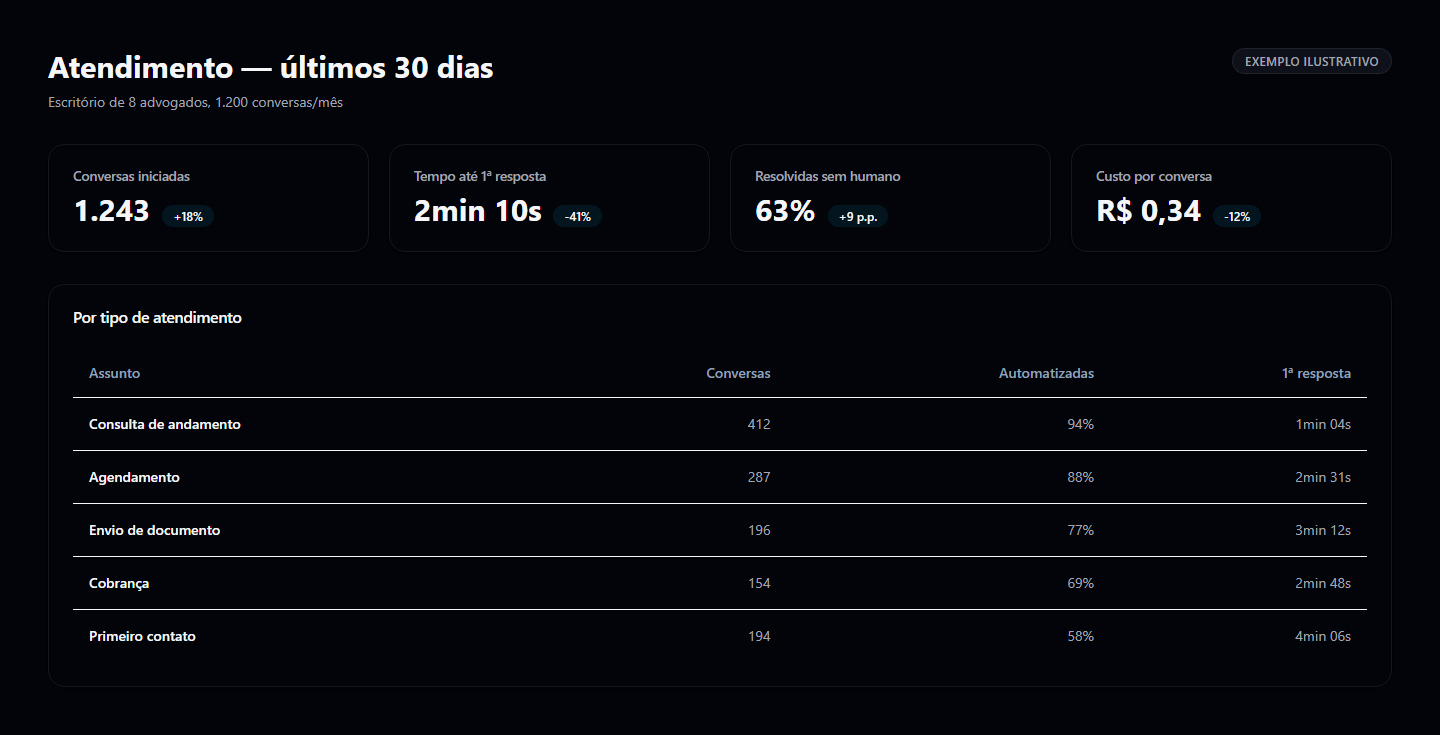
O painel acima é exemplo ilustrativo — os números são de fixture, não de cliente —, mas o formato é o ponto. Quando o atendimento é quebrado por assunto, aparece a distância entre uma consulta de andamento, que resolve em uma ida e volta, e um primeiro contato, que resolve em muitas. É nesse recorte que uma redução de tokens por tarefa vira dinheiro, e é nele que ela evapora se o fluxo for prolixo.
Três ressalvas, porque esse é o tipo de número que vira decisão de orçamento.
"Até 30%" é teto, não média. A palavra "até" está no anúncio e não é enfeite. O ganho real depende da tarefa, e a Anthropic mede em codificação e trabalho de conhecimento, não em atendimento jurídico por WhatsApp.
O número é do fornecedor. Não é medição independente, e não é medição nossa. A única forma de saber o que acontece na sua operação é medir antes e depois, no seu próprio tráfego.
Trocar de modelo não é trocar uma string. Um modelo que responde em menos tokens pode responder diferente. Se o fluxo depende do formato da saída — um JSON que alimenta o CRM, um texto que vai direto ao cliente —, a troca precisa de uma rodada de verificação antes de ir para produção.
As outras duas publicações da semana dizem a mesma coisa por caminhos diferentes.
Em 1º de outubro a Anthropic divulgou números do Barclays: mais de 16 mil funcionários usando um assistente de conhecimento interno, mais de um milhão de buscas, cerca de 120 mil e-mails processados por dia na área de mercados, e a projeção de chegar a 50% da população de desenvolvedores até o fim de 2026. Vale separar o que esses números são do que não são. São números de adoção e de volume, publicados pelo próprio fornecedor. Não há no anúncio redução de tempo de processamento, economia medida ou variação de satisfação do cliente. Escala de uso não é, sozinha, resultado.
No dia 2, veio o anúncio de US$ 100 milhões para formar 10 mil engenheiros de implantação até o fim de 2027, com empresas como Accenture, Deloitte e McKinsey entre as participantes. O formato é de residência médica: bootcamp presencial com cenários simulados, avaliação, e depois 12 semanas conduzindo um projeto real dentro da própria empresa, com mentoria.
Um fornecedor de modelo não investe US$ 100 milhões em formar gente para implantar se o gargalo estivesse no modelo. O diagnóstico embutido no anúncio é que a distância entre "o modelo consegue" e "a empresa colhe" é preenchida por trabalho de implantação: mapear o processo, decidir o que automatizar, medir o que saiu.
Para um escritório, isso se traduz direto. A pergunta útil não é qual modelo lidera o ranking desta semana. É quais três fluxos do seu atendimento você consegue descrever com precisão suficiente para automatizar e depois medir. Na implantação da Touch, é esse o conteúdo do pacote: a IA é treinada com o contexto do escritório e entra em fluxos definidos de atendimento, cobrança e contratos, integrada ao sistema jurídico e ao ZapSign. A parte que decide o resultado é a definição desses fluxos, não a escolha do modelo.
WhatsApp API e mercado
Sem novidade confirmada nesta semana — e aqui o motivo precisa ser dito, porque não equivale a "não aconteceu nada".
Esta edição rodou em um ambiente cuja política de rede bloqueou o acesso a developers.facebook.com, business.whatsapp.com e about.fb.com. Nenhuma página de documentação ou changelog da Meta pôde ser aberta e datada nesta execução. Pela regra que seguimos — a data tem que estar na página buscada, não no resumo do buscador —, nada atribuído à Meta entra nesta edição.
Isso tem uma consequência prática que vale registrar. A mudança que cobrimos na edição de 21 de setembro tinha 1º de outubro como data de vigência: a cobrança por mensagem das conversas de serviço e dos templates de utilidade enviados dentro da janela de 24 horas. Essa data passou durante a semana. Não conseguimos reconfirmar na documentação da Meta que a mudança entrou em vigor como anunciada, nem verificar as tabelas por país. Blogs de BSP afirmam que sim — eles não são a Meta, e não repassamos como fato confirmado o que não conseguimos abrir na fonte primária.
O que isso significa para você é bem concreto: se o escritório usa a API, a fatura de outubro é onde a resposta aparece primeiro, e aparece antes de qualquer confirmação em documentação. Vale olhar a primeira fatura do mês linha a linha, em vez de esperar o fechamento.
Métricas de escritório
Sem novidade relevante nesta semana. Não encontramos publicação de fonte primária datada dentro da janela de sete dias que justificasse uma entrada aqui, e as fontes que costumamos usar nesta trilha também estavam fora de alcance a partir deste ambiente.
Não vamos preencher a seção com média de mercado sem link. Quando não há dado público novo, essa é a frase honesta.
O que sobra de útil, sem número inventado, é o indicador que a trilha de IA acima torna necessário: custo de IA por atendimento resolvido. Ele não aparece em relatório setorial, e não precisa aparecer — é interno, e cada escritório calcula o seu.
Dois cuidados no cálculo. Conte apenas atendimentos encerrados dentro do período, para não dividir o custo de um mês pela resolução de outro. E separe por tipo de atendimento: a média agregada esconde exatamente o fluxo caro que valeria corrigir.
Um aviso sobre o próprio indicador: qualquer "média do setor" que você encontrar para ele deveria vir acompanhada de link para o levantamento, com ano e metodologia. Nós não temos esse link, então não damos esse número.
O que fazer nesta semana no Touch
- Abra a primeira fatura de outubro da sua conta WhatsApp Business linha a linha. É onde a mudança de preço anunciada para 1º de outubro aparece antes de qualquer confirmação em documentação.
- Calcule o custo de IA por atendimento resolvido do mês passado. É uma divisão, com dados que você já tem.
- Separe esse custo por tipo de atendimento. O fluxo mais caro é o primeiro candidato a encurtar.
- Antes de trocar o modelo que está em produção, rode seus fluxos de saída estruturada no modelo novo. Menos tokens pode significar saída diferente.
- Se ainda não rodou o diagnóstico de conformidade da Touch, rode: são 37 fatores em 9 seções, cerca de 8 minutos, sem cadastro e sem acesso à sua conta. Ele acompanha o ratio inbound:outbound e o monitoramento do webhook
account_update, que continuam valendo independentemente de preço.